现代Transformer精读-02:RoPE位置编码与YaRN外推
本文精读
model_minimind.py的precompute_freqs_cis(62–78 行)与apply_rotary_pos_emb(80–84 行)。本文将从绝对正弦位置编码与可训练位置编码出发,一路走到旋转位置编码(RoPE)的数学与实现,最后讲 MiniMind 的 YaRN 长文本外推配置。
1. 位置编码:从绝对编码到旋转编码
1.1 自注意力看不见顺序
我们注意到注意力公式
只比较每个 token 与其他 token的配对,与它们在序列中的先后无关。严格地说:注意力输出对输入序列的置换是等变的(permute 输入,输出跟着 permute,但位置信息完全丢失)。于是同一个模型看到这两句话,会给出一模一样的表示,故位置信息必须由外部显式注入,这就是位置编码(Positional Encoding)存在的理由。
1.2 两个经典方案(绝对正弦与可训练)
① 绝对正弦位置编码(Vaswani et al., 2017)
- 加法注入:
embedding + PE,PE 的形状与 embedding 相同( 维分 对 sin/cos); - 优点:与序列长度无关(任意长都能生成)、无需训练;
- 缺点:编码的是绝对位置。模型若想知道第 个词与第 个词的相对距离 ,只能靠三角恒等式自己挖掘:
相对信息藏在 sin/cos 的恒等关系里,需要模型自主学习才能观察到。
② 可训练位置编码(BERT / GPT 系)
- 每个位置一个可训练向量 ,查表后同样加到 embedding 上;
- 优点:简单直接、完全可学习;
- 缺点:只能在训练见过的长度内工作超出
max_len就没有向量可查,外推能力为零;而且它同样是绝对位置视角。
1.3 RoPE
把位置的数值升级成旋转的角度:给 Query 和 Key 各转一个角度,角度差就是相对位置。
2. 旋转的数学
2.1 把向量放进复数平面
RoPE 的第一步操作:把维度 的向量切成 组二维对 ,每一组看作复数平面上的一个点:
位置 在复数里是一个非常自然的动作乘一个单位复数:
,所以这个乘法不改变向量长度,只旋转角度 。换个角度看(对应实向量):
2.2 旋转后内积只依赖相对位置
当取位置 的查询向量 与位置 的键向量 的内积时(复向量内积取实数部 ):
记 (只由 q、k 的内容决定),展开:
内积表达式中, 和 永远以差值 的形式成对出现绝对位置消失了,只剩相对位置。,也是它名字的由来(Rotary Position Embedding)。
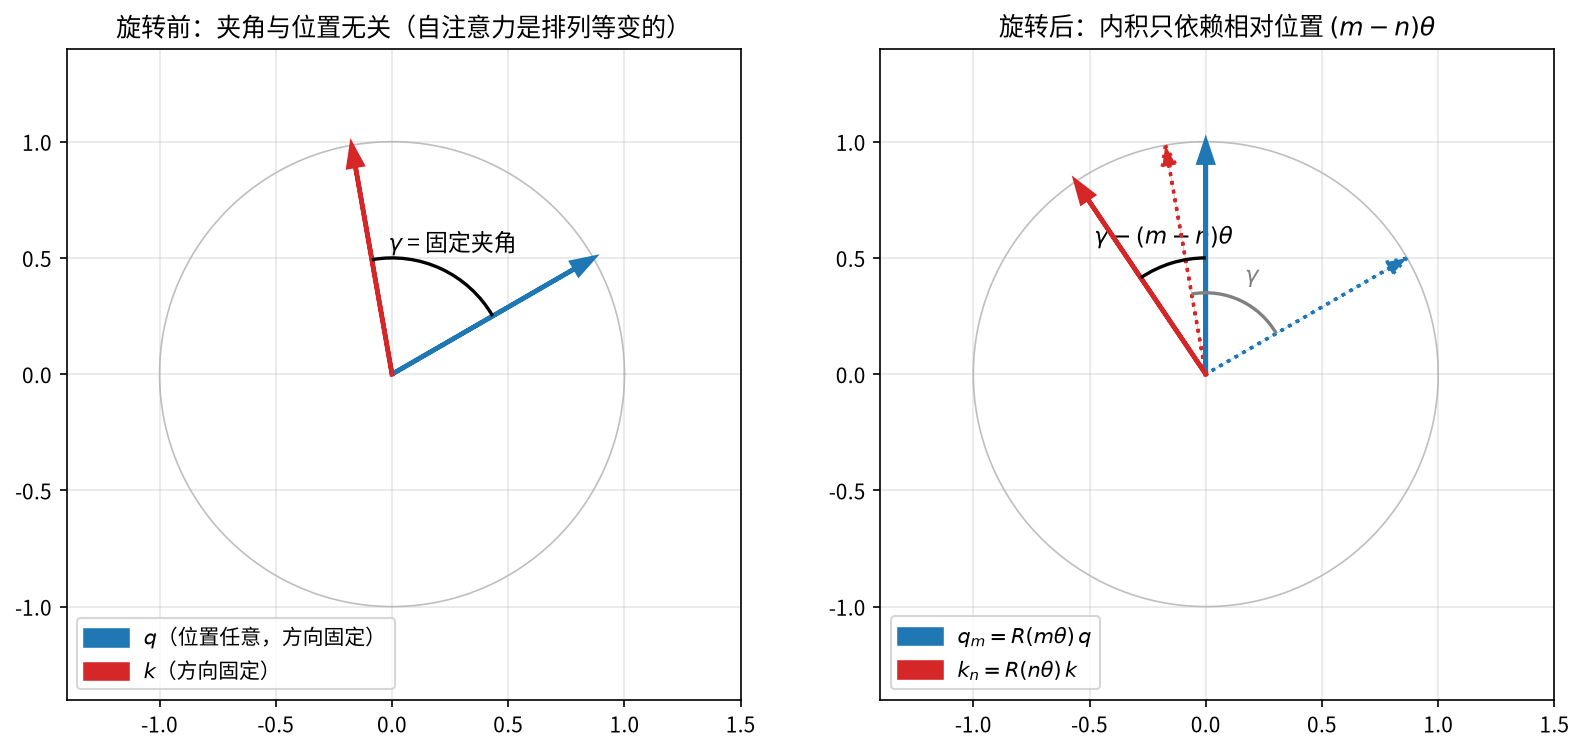
有图可知:左边 q、k 不转时夹角固定(与位置无关);右边各自旋转后,夹角 里只出现 。
一个 维向量有 个二维对,位置 的完整旋转就是每个二维对各自旋转、互不干扰的分块对角矩阵:
每个块的角度 由该块的角速度 决定。 的选择正是下一节代码里 precompute_freqs_cis 做的。
2.3 为什么只转 q 和 k,不转 v
注意力打分用 q、k 的内积(03-自注意力机制精读),v 只是被加权后求和的内容。位置信息要影响的是谁该注意谁(打分),旋转 v 只会把内容向量拧来拧去,不带来位置信息,还破坏内容语义。所以 RoPE 只作用在 q、k 上。
3. 代码分析:precompute_freqs_cis 与 rotate_half
3.1 角速度:指数衰减的频率
先看函数前半段(忽略 YaRN 分支,第 5 节专讲):
freqs = 1.0 / (rope_base ** (torch.arange(0, dim, 2)[: (dim // 2)].float() / dim))torch.arange(0, 96, 2) 生成偶数 [0,2,4,…,94](共 48 个),除以 dim=96 得 [0, 1/48, …, 47/48],再取 base=1e6 的负幂:
这正是 2.3 节说的每个二维对专属角速度:
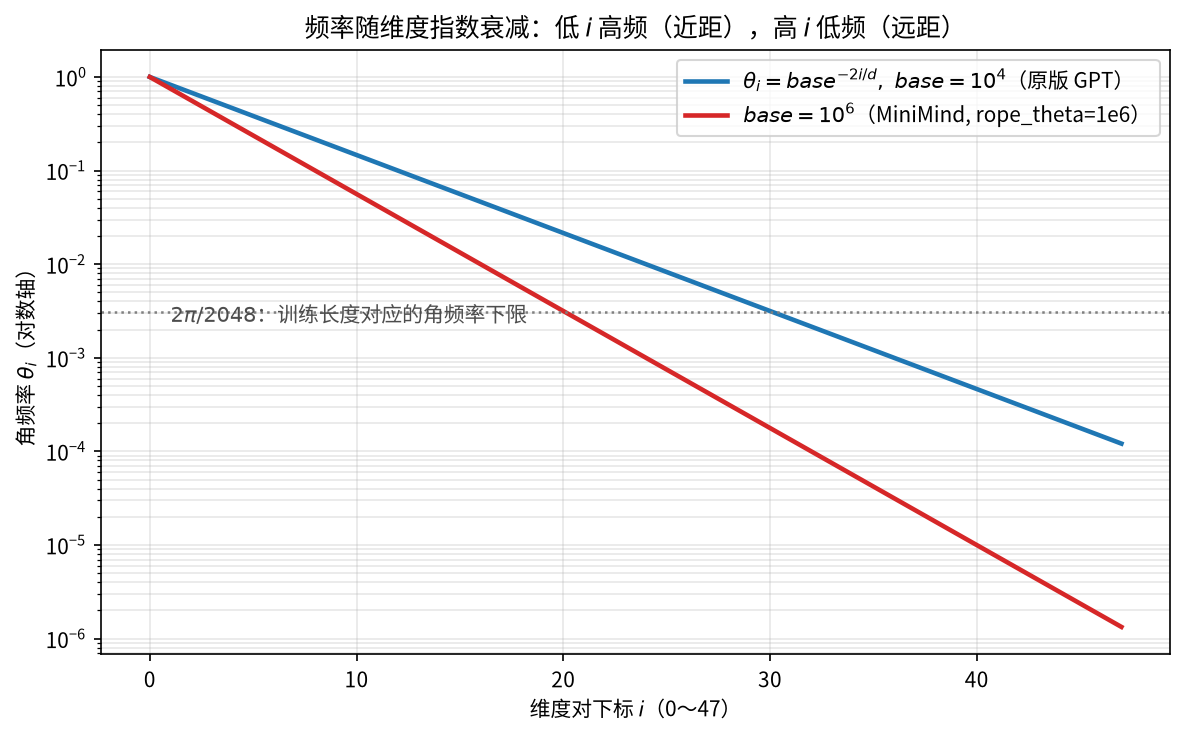
- 指数衰减:与 2017版 正弦编码同构(那里是 ),目的是多尺度覆盖见下图: 小 → 大 → 高频,负责分辨相邻位置; 大 → 小 → 低频,负责分辨远距离位置。
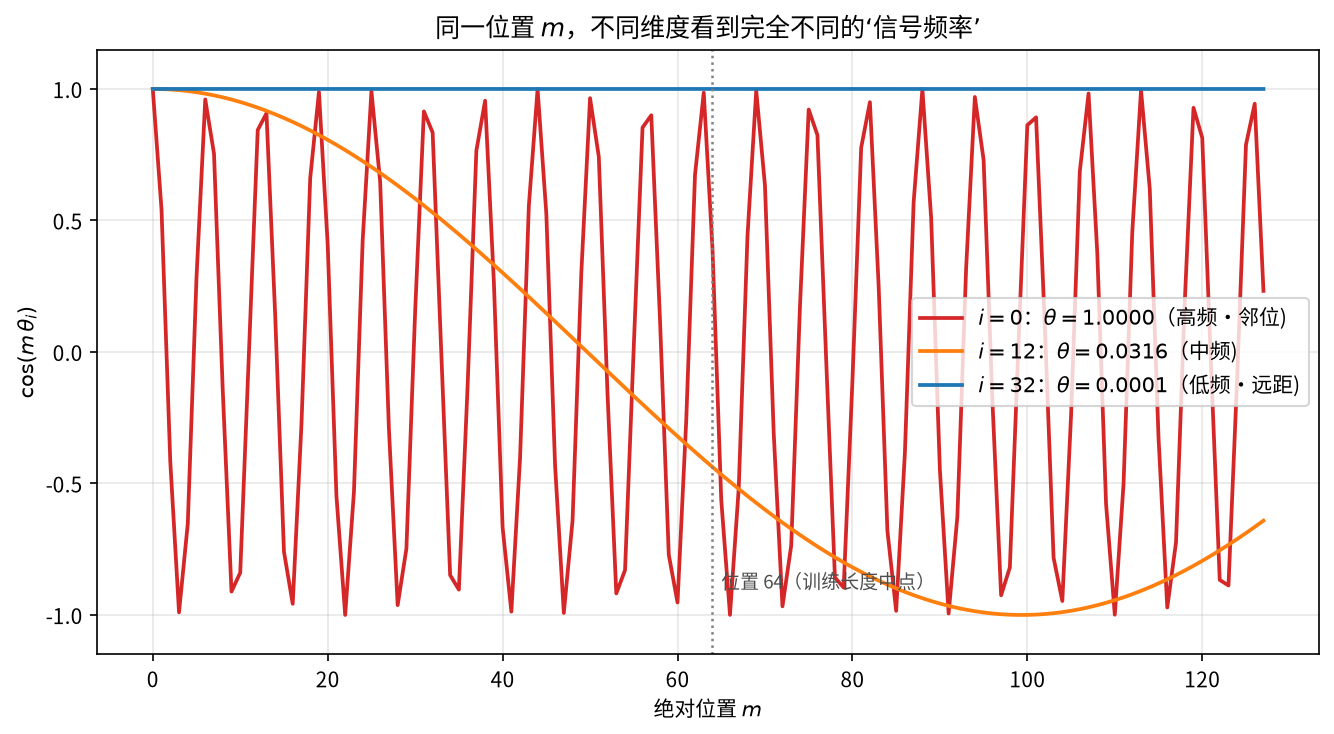
- 高/低频的失效模式不同,见下图:同一位置 ,不同维度看到完全不同的信号频率。高频维度(,)在几十个位置内就振荡好几个周期超过周期后无法区分位置(alias, 与 给出相同 cos);低频维度则在整个上下文里几乎是一条平线它能稳定地区分长距离,但不能提供细粒度位置。
- base 的作用:base 越大,所有 整体越小(曲线整体下移)。MiniMind 用
rope_theta=1e6(原版 1e4),相当于把整个频率谱往低频方向平移每个维度看得更远,对长文本更友好,这是后续外推(第 5 节)的地基。
3.2 位置-频率表:torch.outer
t = torch.arange(end, device=freqs.device)   # end = max_position_embeddings = 32768
freqs = torch.outer(t, freqs).float()        # [32768, 48],第 m 行 = [mθ₁, …, mθ₄₈]
outer 做外积:第 行恰好是位置 的 48 个旋转角 。整张表 [32768, 48] 就是全部位置 × 全部维度对的旋转角网格预计算一次,前向时按需切片(01 篇 §6.3 的 start_pos 切片就是在这里摸表)。
3.3 cos/sin 拼接
freqs_cos = torch.cat([torch.cos(freqs), torch.cos(freqs)], dim=-1) * attn_factor   # [32768, 96]
freqs_sin = torch.cat([torch.sin(freqs), torch.sin(freqs)], dim=-1) * attn_factor
[32768, 48] 拼成 [32768, 96](= head_dim)。因为在 apply_rotary_pos_emb:
def rotate_half(x):
    return torch.cat((-x[..., x.shape[-1] // 2:], x[..., : x.shape[-1] // 2]), dim=-1)
    # 后一半取负放前、前一半放后

q_embed = (q * cos.unsqueeze(1)) + (rotate_half(q) * sin.unsqueeze(1))
把向量前 48 维当实部、后 48 维当虚部(即 )。旋转 的实部/虚部为:
而代码算的正是:
所以各拼接两份 cos/sin = 给实部组和虚部组各准备一份同样的角表;rotate_half 负责把虚部取负换位这两个操作合并。这与 2.1 的旋转矩阵完全等价:
unsqueeze(1) 的作用是让 […, 96] 的角表在序列维上广播对齐 [B, heads, S, 96] 的 q/k。
4. 位置表如何进注意力
RoPE 与绝对/可训练编码还有一个常被忽略的差异:注入点不在 embedding 处,而在注意力内部。看 Attention.forward 的前五行(111–119 行):
xq, xk, xv = self.q_proj(x), self.k_proj(x), self.v_proj(x)      # ① 投影
xq = xq.view(bsz, seq_len, self.n_local_heads, self.head_dim)    # ② 切成多头
xk = xk.view(bsz, seq_len, self.n_local_kv_heads, self.head_dim)
xq, xk = self.q_norm(xq), self.k_norm(xk)                        # ③ QK-Norm(03 篇详讲)
cos, sin = position_embeddings
xq, xk = apply_rotary_pos_emb(xq, xk, cos, sin)                  # ④ RoPE 注入
# ⑤ ……之后才是 QKᵀ 内积与 softmax(03 篇)
position_embeddings 这份表怎么切片,01-模型骨架与前向回路 已经讲过,这里补充关于start_pos的细节:
- 训练时:
start_pos=0,切片取表的前seq_len行,每个 token 用自己真实的绝对位置; - 推理续写时:
start_pos=已缓存长度,新生成的 token 拿到start_pos+1起的位置编码,详见KV Cache(03-自注意力机制精读 ); - 表只预计算到
max_position_embeddings=32768,对话超出这个长度会切片越界,这时就需要YaRN换表
5. YaRN 长文本外推
5.1 周期覆盖定理
3.1 角速度:指数衰减的频率 里每个维度 都有专属角速度 ,它定义一个波长(走完一个周期需要的 token 数):
位置编码的相位是 训练长度 内维度 的相位被覆盖了
- 高频维度( 短):比如 ,训练长度 内走完 个周期相位在 上被密集采样过,任意位置 的相位 (无论 多大)都会 alias 回训练中已经见过的某个相位值。模型对这个维度所有相位都有了解,可以直接外推;
- 低频维度( 长):比如 ,训练内相位只覆盖了 半圈周期都没走完。推理时 的相位滑进训练从未见过的相位区间,不可以直接外推
从整体降低角频率到 YaRN
要让远处相位重新落入模型熟悉的区域,直觉是让远处位置的旋转角变小,相当于把长序列的位置压缩回训练范围内的相位。各家做法:
| 方案 | 做法 | 问题 |
|---|---|---|
| 直接放大 base | 所有 按同一比例变小 | 高频维度也变慢,相邻位置精度损失 |
| NTK-aware(2023) | 只放大 base 中的高频部分,保持高频不动 | 比盲放大好,但高频/低频的划分是硬的 |
| YaRN(2023) | 软过渡:低频维度频率压缩 、高频维度完全保留、中间线性过渡 | 目前的主流选择 |
YaRN(Yet another RoPE extensioN)的两个关键改进 :① 频率重缩放按维度软过渡(ramp);② 注意力的温度补偿(attention_factor)。
5.3 代码逐行:YaRN 分支
# precompute_freqs_cis 内(69–73 行)
if end / orig_max > 1.0:                                     # 只有"要覆盖的长度 > 训练长度"才启用
    inv_dim = lambda b: (dim * math.log(orig_max / (b * 2 * math.pi))) / (2 * math.log(rope_base))
    low, high = max(math.floor(inv_dim(beta_fast)), 0), min(math.ceil(inv_dim(beta_slow)), dim // 2 - 1)
    ramp = torch.clamp((torch.arange(dim // 2, device=freqs.device).float() - low)
                       / max(high - low, 0.001), 0, 1)
    freqs = freqs * (1 - ramp + ramp / factor)               # 频率重缩放
5.3.1 启用条件
end=32768、orig_max=2048,比值 16 > 1 。训练时 rope_scaling=None 走纯 RoPE 表(4. 位置表如何进注意力 的表长即上限)。
5.3.2 inv_dim:从波长反解维度下标
low/high 是维度下标,但设计者想表达的边界是波长。波长 ,令 ( 个 token),反解 :
代入 MiniMind 的数值():
| 边界 | 波长 → 对应维度 | 数值 | 物理含义 |
|---|---|---|---|
| : | 波长 = 64 tokens(训练内 32 个周期绝对安全区上界) | ||
| : | 波长 = 恰好等于训练长度(1 个周期临界点) |
5.3.3 ramp 与 clamp
low, high = max(math.floor(inv_dim(beta_fast)), 0), min(math.ceil(inv_dim(beta_slow)), dim // 2 - 1)
ramp = torch.clamp((torch.arange(dim // 2, device=freqs.device).float() - low)
                   / max(high - low, 0.001), 0, 1)
(i - low) / (high - low) :把维度下标 线性映射到 离开 越远,被压缩的程度越大。
torch.clamp(·, 0, 1) :clamp(= clip)把张量截断进 :
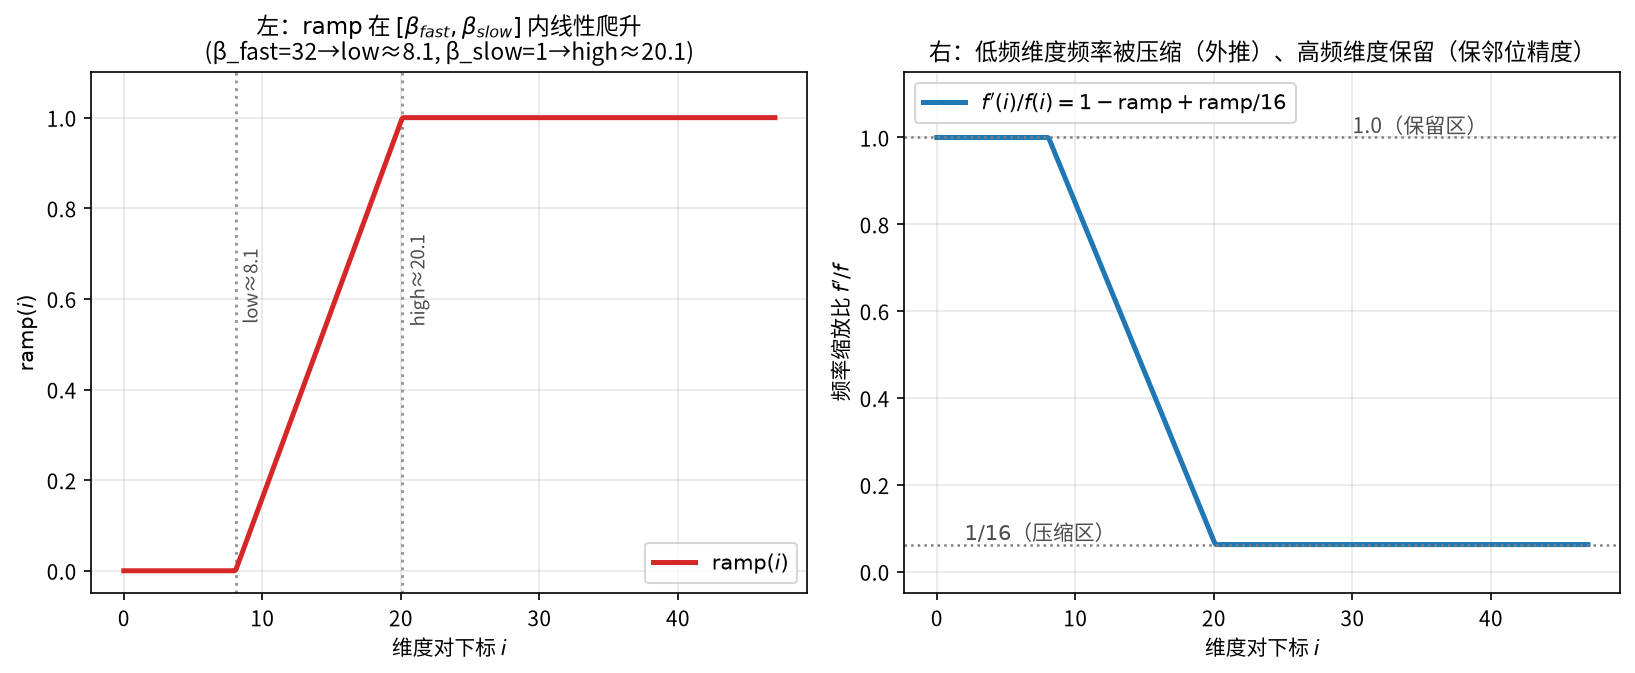
为什么必须 clamp:当 时 ,当 时 。如果不截断,ramp 会变成负数或大于 1,freqs * (1-ramp+ramp/16) 会给高频维度放大频率、给极低频维度产生负频率彻底破坏相位。clamp 让保留区()与压缩区()变成两段平坦的常数,只有 内是斜坡:
floor/ceil + max(…,0)/min(…, d//2−1) :inv_dim 是连续值,维度下标必须是整数floor(下取整 )与 ceil(上取整 )把连续边界收拢成整数;再与 和 夹紧,防止某些(base 极大 / orig 极小)组合下 inv_dim 越出维度范围。
5.3.4 频率重缩放
沿用 (注意 ,):
| 波长 | 训练内周期数 | ramp | 区域 | |||
|---|---|---|---|---|---|---|
| 0 | 1 | 6.3 | 325 | 0 | 1 | 高频保留 |
| 8 | 0.1 | 62.8 | 32.6 | 0 | 0.1 | 保留区上界(low) |
| 15 | 0.0133 | 471 | 4.3 | 0.54 | ≈0.0066 | 过渡区 |
| 21 | 0.00237 | 2650 | 0.77(<1) | 1 | ≈0.000148 | 压缩区起点(high) |
| 47 | 4.7M | 0.0004(<<1) | 1 | ≈ | 深压缩区 |
对照 5.1 的周期覆盖定理看这表: 的维度训练里都见过几十到几百个周期(外推安全)→ 频率原封不动; 的维度连一个周期都没走完(相位陌生)→ 频率砍掉 16 倍压缩后它们在新位置 处的相位 ,恰好折算回训练分布内熟悉的相位。过渡区()线性渐变,避免相邻维度相位突变造成注意力打分的跳变。
5.4 MiniMind 的配置与用法
Config 里的 YaRN 参数(31–39 行):
self.rope_scaling = {
    "beta_fast": 32,            # 高频保留区的波长下界(低i维度)
    "beta_slow": 1,             # 低频压缩区的波长上界(高i维度)
    "factor": 16,               # 低频频率压缩倍数
    "original_max_position_embeddings": 2048,   # "训练长度"
    "attention_factor": 1.0,
    "type": "yarn"
} if self.inference_rope_scaling else None # 默认 False = 不启用- 默认关闭(
inference_rope_scaling=False),训练与常规推理都用纯 RoPE 表; - 需要长文本外推时在推理侧开启(
eval_llm.py --inference_rope_scaling),于是生成的频率表换成 YaRN 版
5.5 小结
YaRN =把远处位置的相位,拽回模型熟悉的训练分布,高频不动保近距精度,低频降速保远距可分,中间软过渡避免相位突变
6 其他
6.1 本文对应代码
| 代码 / 配置 | 对应小节 |
|---|---|
precompute_freqs_cis(62–78) | [[#3. 代码分析:precompute_freqs_cis 与 rotate_half]]、5.3 代码逐行:YaRN 分支 |
apply_rotary_pos_emb / rotate_half(80–84) | 3.3 cos/sin 拼接 |
rope_theta / max_position_embeddings | 3.1 角速度:指数衰减的频率、4. 位置表如何进注意力 |
inference_rope_scaling + rope_scaling dict(31–39) | 5.4 MiniMind 的配置与用法 |
| RoPE 表如何切片进 Attention | 4. 位置表如何进注意力 + 01-模型骨架与前向回路 |
6.2 延伸阅读
RoPE 原始论文 RoFormer: Enhanced Transformer with Rotary Position Embedding(Su et al., 2021); YaRN 论文 YaRN: Efficient Context Window Extension of Large Language Models(Peng et al., 2023)。
评论