现代Transformer精读-04:稀疏MoE路由与负载均衡
本文精读
model_minimind.py的MOEFeedForward(148–176 行)与 config 的 MoE 字段(41–45 行)。
0. MOEFeedForward
# model_minimind.py 148–176 行
class MOEFeedForward(nn.Module):
    def __init__(self, config: MiniMindConfig):
        super().__init__()
        self.config = config
        self.gate = nn.Linear(config.hidden_size, config.num_experts, bias=False)          # 路由门控
        self.experts = nn.ModuleList([FeedForward(config, intermediate_size=config.moe_intermediate_size)
                                      for _ in range(config.num_experts)])                 # 4 个专家 FFN
        self.act_fn = ACT2FN[config.hidden_act]

    def forward(self, x):
        batch_size, seq_len, hidden_dim = x.shape
        x_flat = x.view(-1, hidden_dim)                                                     # ① 摊平 [B,S,768]→[B*S,768]
        scores = F.softmax(self.gate(x_flat), dim=-1)                                       # ② 路由打分
        topk_weight, topk_idx = torch.topk(scores, k=self.config.num_experts_per_tok, dim=-1, sorted=False)  # ③ top-1 选取
        if self.config.norm_topk_prob: topk_weight = topk_weight / (topk_weight.sum(dim=-1, keepdim=True) + 1e-20)  # ④ 重归一化
        y = torch.zeros_like(x_flat)
        for i, expert in enumerate(self.experts):                                           # ⑤ 逐专家稀疏聚合
            mask = (topk_idx == i)
            if mask.any():
                token_idx = mask.any(dim=-1).nonzero().flatten()
                weight = topk_weight[mask].view(-1, 1)
                y.index_add_(0, token_idx, (expert(x_flat[token_idx]) * weight).to(y.dtype))
            elif self.training:
                y[0, 0] += 0 * sum(p.sum() for p in expert.parameters())                   # ⑥ 训练期零梯度
        if self.training and self.config.router_aux_loss_coef > 0:                          # ⑦ 负载均衡 aux loss
            load = F.one_hot(topk_idx, self.config.num_experts).float().mean(0)
            self.aux_loss = (load * scores.mean(0)).sum() * self.config.num_experts * self.config.router_aux_loss_coef
        else:
            self.aux_loss = scores.new_zeros(1).squeeze()
        return y.view(batch_size, seq_len, hidden_dim)                                      # ⑧ 还原 [B,S,768]
1. MoE 要解决什么
1.1 MoE 的架构:一个 多分流 的 FFN
回看 01 篇的 01-模型骨架与前向回路,普通 FFN 是一个 单通道 :
FeedForward.forward: down(act(gate(x)) * up(x)) # 每个 token 走唯一的 FFNMoE 把它变成 一个门控 + 多条专家通道 (§0 的 152–153 行):
self.gate    = nn.Linear(hidden, num_experts)      # ① 路由:决定走哪个专家
self.experts = ModuleList([FeedForward(...) for _ in range(num_experts)])   # ② 4 条专家通道
每个 token 经过 gate 打分(156–163 行),被分配到专家 ,只走这条通道,最后把专家输出按权重加权回主路。
1.3 为什么只替换 FFN,不动注意力
MoE 只把 MiniMindBlock.mlp(184 行)换成 MOEFeedForward,不改变注意力(self_attn = Attention(config))。理由是:
- FFN 是模型里参数密度最高的部分(01 篇 §9.1:FFN 占每层约 76% 参数),是最值得稀释的地方;
- 注意力是全局依赖结构(03-自注意力机制精读 中所有位置两两交互),难以按 token 稀疏化;FFN 是逐 token 独立的逐点变换(position-wise),天然适合 每个 token 选不同专家
1.4 config 41–45 行
| 字段 | 取值 | 含义 |
|---|---|---|
num_experts | 4 | 每层放的专家 FFN 数 |
num_experts_per_tok | 1 | 每个 token 激活的专家数(top-1,最简) |
moe_intermediate_size | 2432(默认 = intermediate_size) | 专家 FFN 的中间维度,默认与 Dense 全尺寸一致 |
norm_topk_prob | True | top-k 选后用不用重归一权重 |
router_aux_loss_coef | 5e-4 | 负载均衡辅助损失的权重 |
注意 moe_intermediate_size 默认等于 intermediate_size(2432)MiniMind 的每个专家是一个 全尺寸 FFN,不是瘦专家。4 个全尺寸专家参数 /层,即198M-A64M
2. 路由:gate(x) 与 softmax
2.1 gate 线性层
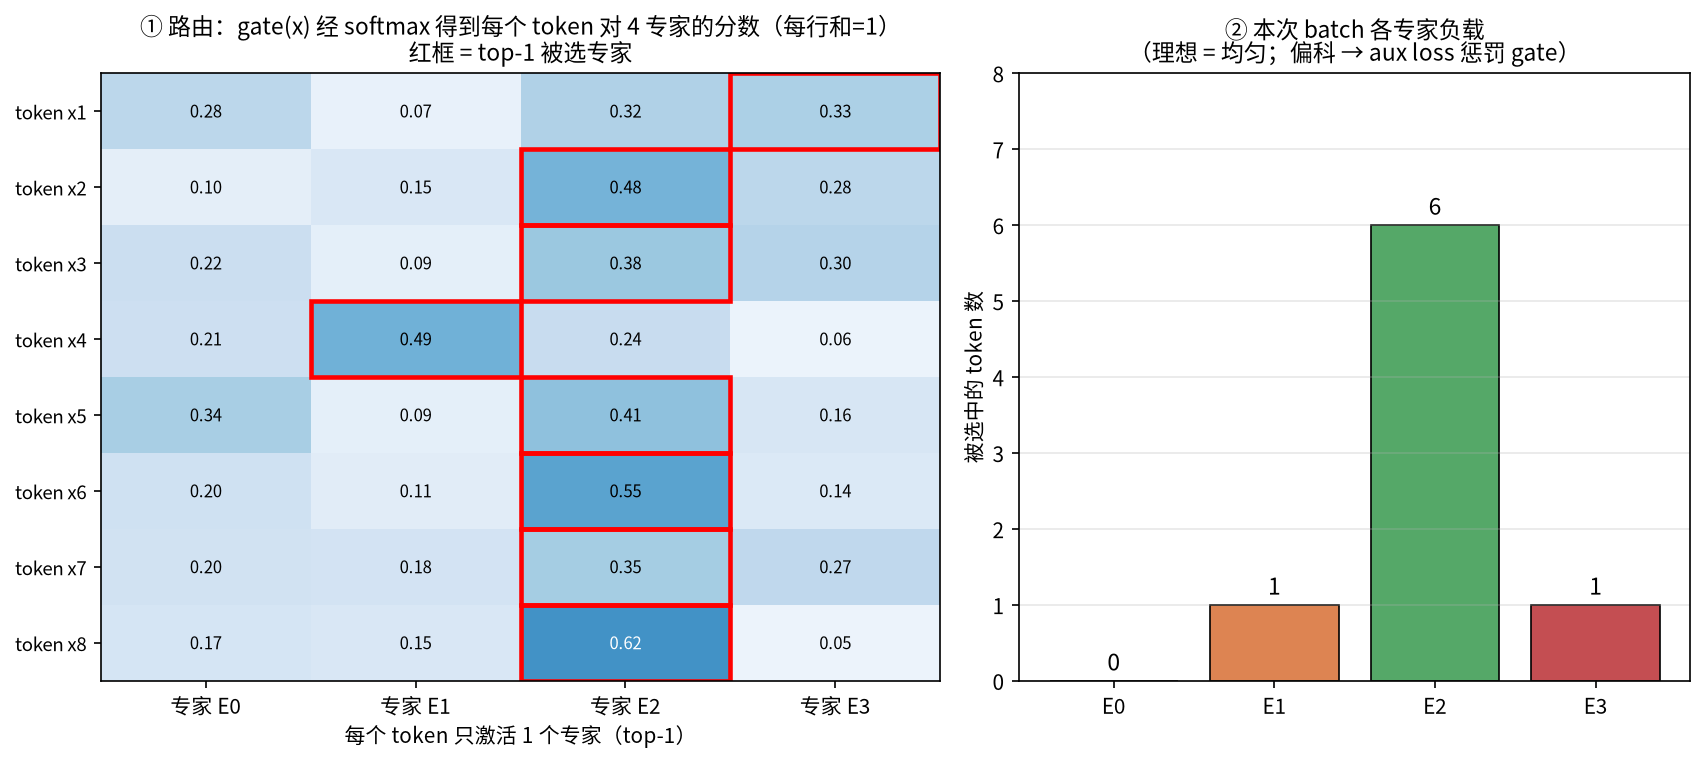
self.gate = nn.Linear(config.hidden_size, config.num_experts, bias=False)   # 768 → 4
x_flat = x.view(-1, hidden_dim)                  # [B,S,768] → [B*S,768]
scores = F.softmax(self.gate(x_flat), dim=-1) # [B*S, 4],每行和 = 1- 输入 768、输出 4(
num_experts=4),权重形状[4, 768](约 3k 参数) - 与注意力里的 q/k/v 是同一类东西:都可学习的投影。区别在输出维度:q/k/v 投影到内容空间,gate 投影到 专家选择空间 为每个 token 产出 4 个 logit。
2.2 软选择
scores 本身是软的(连续分数),topk 挑出最大那个才变成硬选择([[#3. top-1 与 norm_topk_prob]])。两点值得记住:
- 分数用于加权:被选专家的输出要乘以它的分数(§0 的 168 行
* weight) - 分数用于负载均衡:
scores.mean(0)会进 aux loss(§0 的 173 行)即使某个专家没被选中,它的平均信任度也会成为惩罚信号。这让 gate 成为端到端可训练的核心
3. top-1 与 norm_topk_prob
3.1 topk
topk_weight, topk_idx = torch.topk(scores, k=self.config.num_experts_per_tok, dim=-1, sorted=False) # k=1torch.topk(scores, k=1, dim=-1):对每个 token,挑出分数最大的 1 个专家,返回:topk_weight:被选专家的分数[B*S, 1];topk_idx:被选专家的下标[B*S, 1](0–3);
top-1 是 num_experts_per_tok=1 的最简形态:每个 token 走 1 个专家。这是 MiniMind 的选择;更大的生产型 MoE(Mixtral / DeepSeek)通常用 top-2/top-8更多专家并行、负载更匀,但计算和路由复杂度上升。
3.2 norm_topk_prob:被截断的 softmax 需要重新归一
if self.config.norm_topk_prob:
    topk_weight = topk_weight / (topk_weight.sum(dim=-1, keepdim=True) + 1e-20)
这里隐藏一个 softmax 与 top-k 的 失配 :
scores的每个分量是对 4 个专家归一的和为 1 的分数;- 但
topk_weight只取其中 top-1(1 个),其余 3 个专家被扔掉被选专家的原始分数不再成立(它原本的分母含被丢弃专家的量)。
例如某 token 的分数 [0.4, 0.3, 0.2, 0.1],top-1 得到 0.4。但这 0.4 是 占总信任度 40% 的意思;一旦只保留一个专家,逻辑上应该把这个 40% 当作 100%(MoE 里每个 token 的路由权重应该和为 1)。
4. 稀疏聚合的实现细节
4.1 逐专家循环:只算被路由到的token
y = torch.zeros_like(x_flat)                                   # 输出缓存 [B*S, 768]
for i, expert in enumerate(self.experts):                      # 遍历 4 个专家
    mask = (topk_idx == i)                                     # [B*S,1],该 token 是否选了专家 i
    if mask.any():
        token_idx = mask.any(dim=-1).nonzero().flatten()       # 选中专家 i 的 token 下标
        weight = topk_weight[mask].view(-1, 1)                 # 对应路由权重
        y.index_add_(0, token_idx, (expert(x_flat[token_idx]) * weight).to(y.dtype))
每个 token 只出现在它选中专家的 mask 里
4.2 index_add_
y.index_add_(0, token_idx, val) # y[token_idx] += val (scatter-add)这是 scatter-add:沿 dim=0 按 token_idx 把 val 原位加进 y 的对应行
val 经 .to(y.dtype) 对齐(expert 输出可能与 y 精度不同),避免 dtype 不匹配。
4.3 避免专家死亡的技巧
elif self.training:
    y[0, 0] += 0 * sum(p.sum() for p in expert.parameters())
触发场景:某个专家在本次前向里一个 token 都没被选中(mask.any()=False,上面的 if 分支没走)。此时这个专家的参数没有参与任何计算,也就收不到任何梯度在分布式(DDP / DeepSpeed)训练里,该专家会因 梯度全 0 而不更新,且之后也可能永远不被选中,陷入 专家死亡(expert-death)的恶性循环。
保活的手法很巧妙:
0 * sum(p.sum() for p in expert.parameters())sum(p.sum() for p in ...)把该专家的所有参数和(一个标量)算出来,乘0→ 一个恒等于 0 但依赖所有参数的张量;- 把它累加到
y[0,0],这个 0 就把专家全部参数接进了计算图梯度反向传播时,DDP 的all-reduce会为该专家同步梯度(内容是 0),参数保持可更新状态 y[0,0]加 0 不影响真实输出(),纯粹是借一个出口把计算图连起来 。
5. 负载均衡 aux loss
5.1 路由会自我强化 ,然后偏科
gate 训练初期接近随机,但梯度会让偏科变得越来越严重:
- 某个专家碰巧分数高 → 被更多 token 选中 → 拿到更多梯度 → 分数更高 → 更常被选中……
这是正反馈循环,后果有二:
- 少数专家被哄抢:大多数 token 挤向 1–2 个专家,计算资源集中在几个专家上MoE 用满多个专家 的初衷没实现;
- 多数专家被冷落:长期收不到梯度的专家被闲置,甚至滑向 4.3 避免专家死亡的技巧 的 专家死亡 。
要打破这个循环,只靠主任务 loss 进行调节是不可能的,必须显式加一项负载均衡进行惩罚这就是 aux loss(auxiliary loss,也叫 router / load-balancing loss)。
5.2 损失公式
if self.training and self.config.router_aux_loss_coef > 0:
    load = F.one_hot(topk_idx, self.config.num_experts).float().mean(0)
    self.aux_loss = (load * scores.mean(0)).sum() * self.config.num_experts * self.config.router_aux_loss_coef
else:
    self.aux_loss = scores.new_zeros(1).squeeze()
( 为专家数、 为本 batch token 数):
两个关键量:
| 定义 | 代码 | 可导性 | |
|---|---|---|---|
| 专家 被选中的频率(这次 batch 里多少比例的 token 选了它) | one_hot(topk_idx, N).mean(0) | 离散 0/1,不可导 | |
| 专家 的平均 softmax 信任度 | scores.mean(0) | 连续,可导 |
F.one_hot(topk_idx, N)把每个 token 的选中专家下标变成[T, N]的 0/1 独热矩阵,.float().mean(0)沿 token 维平均 → 每专家被选中频率;scores.mean(0)把[T, N]的软分数沿 token 维平均 → 每专家的平均信任度;(load * mean(0))是逐元素乘、再.sum()遍历所有专家求和。
5.3 为什么是 load 和 score 的乘积和 (而非只惩罚一项)
这是 Switch Transformer / DeepSeek-MoE 采用的通用形式,这里的关键在软硬结合:
load是离散的(one-hot 挑选结果,不可导)单惩罚它,梯度无法穿过 top-k 回到 gate;score是连续的(softmax 输出,可导)梯度能从它顺畅流回 gate;- 两者相乘再求和,把 离散的选中负载 和 连续的信任度 绑在一起:
load_i · score_i大,说明专家 既被选中得多、又被信任得高路由偏斜最严重,惩罚也最大。梯度经score传导,gate就学会降低这种专家的分数、把信任度摊平。
5.4 系数与 归一化基准
* self.config.num_experts(=4):归一化因子。理想均衡时每个专家 、,则 ,乘 → 约等于 1。这样 均衡状态 的 aux loss 被归一化到 基准,不随专家数放大,coef才好调(无论 4 个还是 64 个专家,理想值都是 ~1);* self.config.router_aux_loss_coef(=5e-4):相对主任务 loss 的权重。5e-4是个很温和的值MoE 的优化仍由主任务(自回归 CE loss)主导,aux loss 只是 轻轻拉一下 ,确保路由不偏斜即可。若调得过大,会牺牲主任务性能(模型被 强迫均分 而损失精度)。
5.5 图示(负载分布)
这次 batch 里 4 个专家各自被选中的 token 数。理想 = 均匀(各 2 个);偏科(如图中某个专家拿到 5 个)就会让 load·score 变大、aux_loss 变大,从而反向惩罚 gate。
6. Dense 和 MoE 的参数构成
6.1 每层一个专家的成本(全尺寸 FFN)
- 一个 FFN(SwiGLU,intermediate=2432)=
gate_proj(768→2432) +up_proj(768→2432) +down_proj(2432→768):
- MoE 每层有 4 个这样的专家 + 一个
gate(768→4,忽略不计):
6.2 总参数:198M(4 个专家都存)
把模型其他部分(注意力和嵌入)加进来:
| 部分 | 每层 | 8 层 | 说明 |
|---|---|---|---|
| Attention | 1.77M | 14.2M | q/k/v/o 投影,GQA 省 k/v |
| MoE(4 专家 + gate) | 22.4M | 179M | 参数大头 |
| Embedding(tied) | – | 4.92M | 与 lm_head 共享 |
| 总计 | ≈ 198M | 总参数 |
这就是 198M:4 个专家 FFN 全部存进权重。
6.3 激活参数:64M(每 token 只走 1 个专家)
每 token 前向实际用到的参数 = 每层注意力 + 1 个被激活的专家 FFN + gate:
| 部分 | 每层 | 8 层 | 说明 |
|---|---|---|---|
| Attention | 1.77M | 14.2M | |
| 1 个专家 FFN | 5.60M | 44.8M | 只剩 1个 |
| Embedding(tied) | – | 4.92M | |
| 总计 | ≈ 64M | 激活参数 |
6.5 get_model_params
真实代码(trainer_utils.py 18–28 行)不真跑前向,而是用参数总量 + 路由配置直接推出激活参数量,很巧妙:
def get_model_params(model, config):
    total = sum(p.numel() for p in model.parameters()) / 1e6                 # ① 全部参数
    n_routed = getattr(config, 'n_routed_experts', getattr(config, 'num_experts', 0))   # 4
    n_active = getattr(config, 'num_experts_per_tok', 0)                     # 1
    n_shared = getattr(config, 'n_shared_experts', 0)                        # 0(MiniMind 无共享专家)
    expert = sum(p.numel() for n, p in model.named_parameters() if 'mlp.experts.0.' in n) / 1e6  # ② 单个专家的参数
    shared_expert = sum(p.numel() for n, p in model.named_parameters() if 'mlp.shared_experts.0.' in n) / 1e6
    base = total - (expert * n_routed) - (shared_expert * n_shared)          # ③ 非专家部分
    active = base + (expert * n_active) + (shared_expert * n_shared)         # ④ 激活部分
    if active < total: Logger(f'Model Params: {total:.2f}M-A{active:.2f}M')  # ⑤ MoE →    198M-A64M
else: Logger(f'Model Params: {total:.2f}M') # Dense → 64M total:所有权重参数之和;expert:用命名参数匹配'mlp.experts.0.'(专家 0)拿到 一个专家 的参数量;base = total - expert×n_routed:从总量里减掉所有 routed 专家,剩非专家部分(attention + embed + norm + gate + 共享专家),这是每个 token 必然走的部分;active = base + expert×n_active:基础部分 + 每个 token 激活的专家数 × 单个专家。
判断逻辑:active < total(激活比总共少,是 MoE 的稀疏特征)→ 打印 totalM-AactiveM;否则(Dense,激活 = 总参)→ 只打印 total。注意 n_routed/n_shared 用的是 getattr,兼容 DeepSeek 风格的 routed + shared 专家;MiniMind 只有 routed,n_shared=0。
评论