现代Transformer精读-01:模型骨架与前向回路
相关:00-导读
本文精读
model/minimind.py(MiniMind 核心模型,Dense + MoE 双架构)的模型骨架和前向回路部分。除此之外还介绍了RMSNorm和SwiGLU技术
1. 模型形状概览
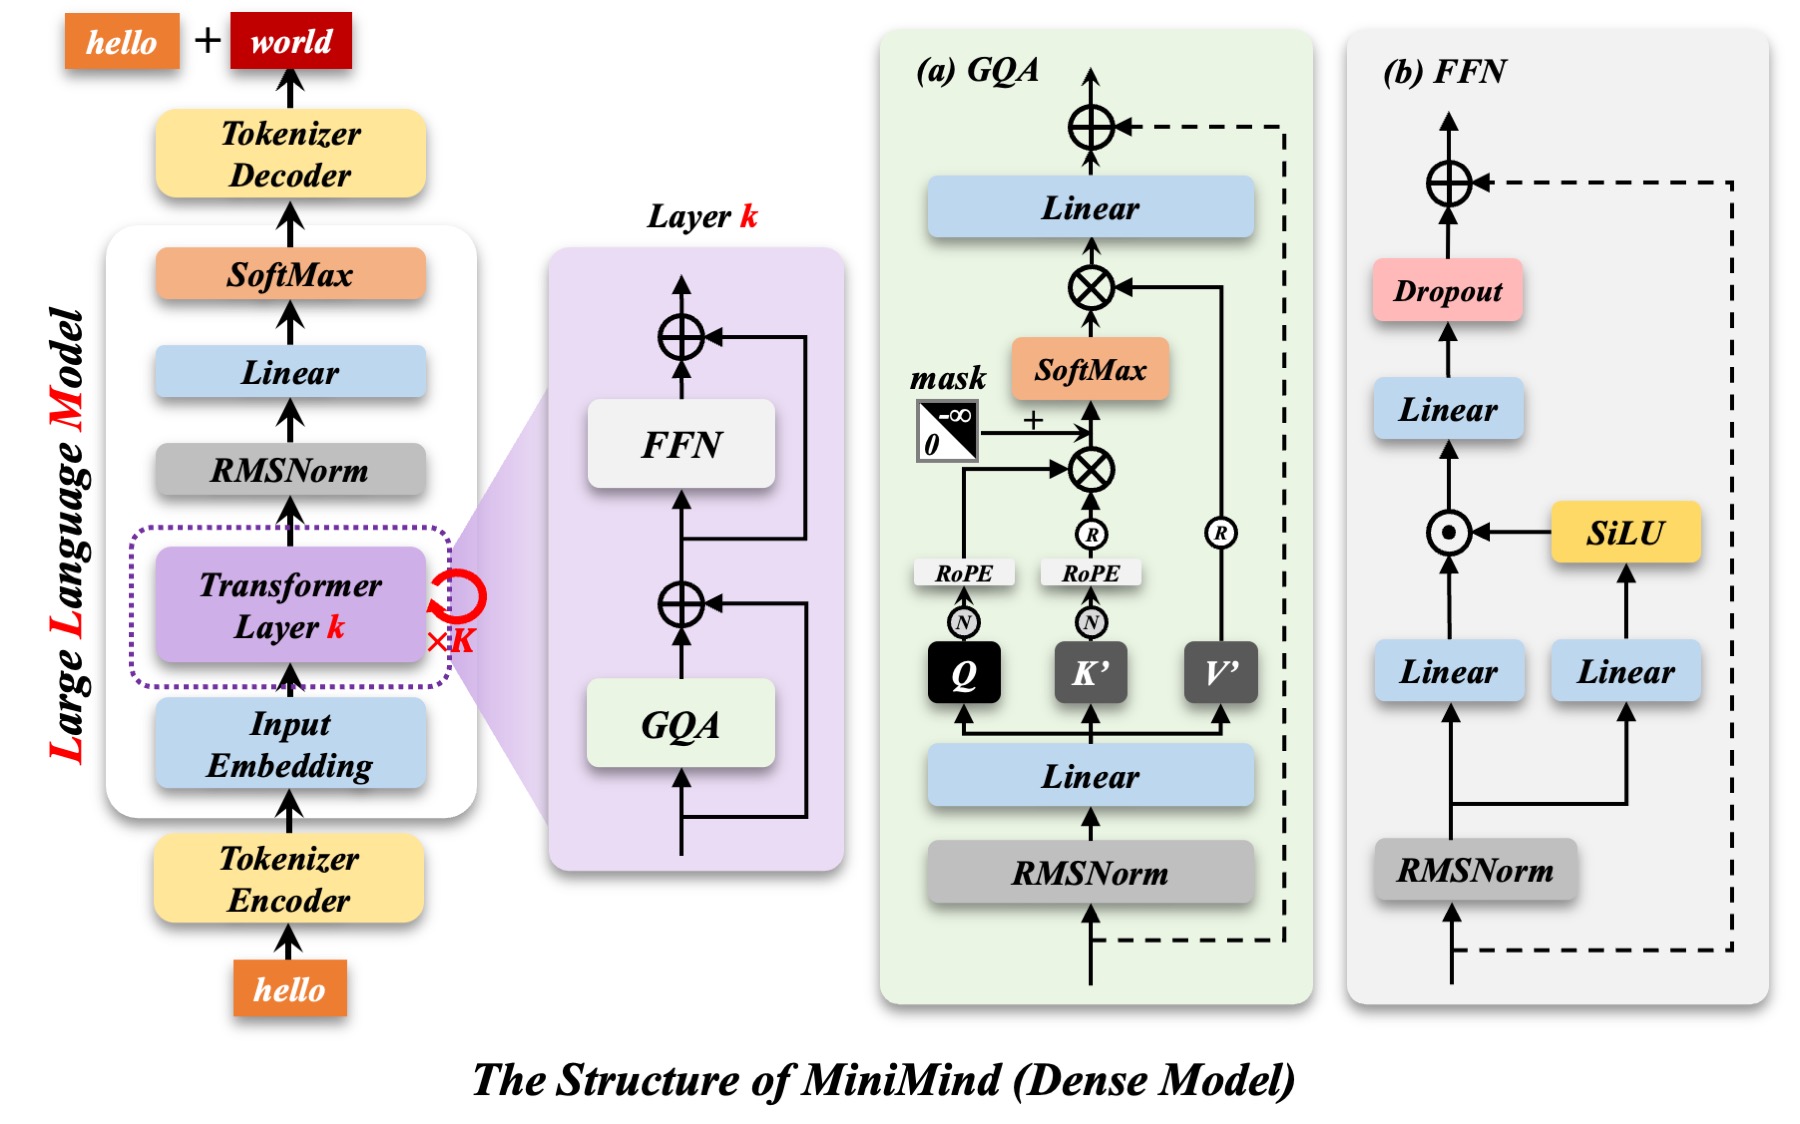
1.1 图例
图从左到右分三栏,其实是对模型的逐步放大:
- 最左栏(Large Language Model):MiniMind 作为完整 LLM 的管线,自下而上
Tokenizer→Embedding→[Transformer Layer×N]→RMSNorm→Linear→SoftMax→Tokenizer。注意最后一层 RMSNorm 在整个堆叠之外、紧跟其后的是投影到词表的 Linear + SoftMax。这正是词表维度只出现在两端的体现。 - 中间紫色栏(Layer k):把某一个
Transformer Layer放大。包含两个子模块:GQA(注意力子模块)和 FFN(前馈子模块),各自都被一条虚线残差旁路环绕。 - 右栏 (a) GQA / (b) FFN:再放大这两个子模块的内部。
1.2 Tensor 形状变化
给一个具体例子:batch 、序列截断长度 、hidden_size=768、词表 6400。
| 阶段 | 形状 | 说明 |
|---|---|---|
| 输入 | [B, S] | 整型 token id |
| Embedding 后 | [B, S, 768] | 从此形状一路不变 |
| 每个 Layer 前 | [B, S, 768] | 8 层都在这个维度上原地叠加 |
| 最终 RMSNorm | [B, S, 768] | 堆叠外最后一个归一化 |
| lm_head 后 | [B, S, 6400] | 拉回词表预测下一个 token |
| loss | [](标量) | shift 对齐后的 cross-entropy |
1.3 残差流:现代 Transformer 的主干道
残差连接本身不是现代才有的:Attention Is All You Need(2017 原版)就有。但现代 Transformer(LLaMA / Qwen / MiniMind)对它的用法,以及由它延展出的残差流视角,和原版是不同的:
| 原版 Transformer (2017) | 现代 MiniMind / LLaMA | |
|---|---|---|
| 归一化位置 | Post-Norm:x = LayerNorm(x + Sublayer(x)) | Pre-Norm:x = x + Sublayer(Norm(x)) |
| 归一化算子 | LayerNorm(减均值、除方差、带 bias) | RMSNorm(只除均方根,无均值减、无 bias,更省更稳) |
| 为什么 | 表达式简单 | 深堆叠数值稳定,可更大学习率、训练更深 |
形状恒定为 768 维的主干道(residual stream),信息穿过多个注意力层。每个注意力 / FFN 模块不直接干预主干道:它先用 RMSNorm 获取主路上的内容,算出一个小增量,再通过残差 ⊕ 写回主路。
# MiniMindBlock.forward  (186–194 行)
residual = hidden_states                                     # ① 先保存主路上的当前值
hidden_states = self.self_attn(                              # ② 注意力:读出→算增量
    self.input_layernorm(hidden_states), ...)                #    进子模块前先 RMSNorm
hidden_states += residual                                    # ③ 增量写回主路(⊕,形状必须一致)
hidden_states = hidden_states + self.mlp(                    # ④ FFN 同上:读出→增量→写回
    self.post_attention_layernorm(hidden_states))
梯度高效传播:反向时,因为主路是一条恒等(identity)路径,梯度可以直接抄近道流回输入,不需要穿过每个子模块的非线性。使得堆叠多个注意力层成为了可能
1.4 读代码的落点
关注 hidden_states 即可:它始终是 [B, S, 768],每个模块都是在它的旁边添加一个增量。
2. MiniMindConfig
# model_minimind.py 10–46 行
class MiniMindConfig(PretrainedConfig):
    model_type = "minimind"
    def __init__(self, hidden_size=768, num_hidden_layers=8, use_moe=False, **kwargs):
        super().__init__(**kwargs)
        self.hidden_size = hidden_size
        self.num_hidden_layers = num_hidden_layers
        self.use_moe = use_moe
        # ... 其余全部通过 kwargs 透传并给默认值
2.1 核心超参逐项解读
| 参数 | 默认值 | 意思 | 原因 |
|---|---|---|---|
hidden_size | 768 | 残差流维度 | |
num_hidden_layers | 8 | 块数 | 64M 级别浅而宽更划算 |
vocab_size | 6400 | 词表大小 | 专属 BPE 词表(见 05-数据管线与自回归目标设计) |
num_attention_heads | 8 | Q 头数 | 768/8=96 的 head_dim |
num_key_value_heads | 4 | KV 头数 | GQA:8 个 Q 头共享 4 组 KV(03-自注意力机制精读) |
head_dim | 96 | hidden_size // num_attention_heads | 每头维度 |
intermediate_size | 2432 | FFN 中间维度 | 见下方重点 |
hidden_act | silu | 激活函数 | SwiGLU 的 σ(x) 即 SiLU(见本文第 4 节) |
max_position_embeddings | 32768 | RoPE 预计算上限 | 配合 rope_theta=1e6 支持长上下文(02-RoPE位置编码与YaRN外推) |
rope_theta | 1e6 | RoPE 基频 | 百万级 base,长文本外推友好(相对原版 10000) |
rms_norm_eps | 1e-6 | 归一化防零 | 保证softmax时数值稳定小常数 |
tie_word_embeddings | True | 共享嵌入 | 入口 embed 与出口 lm_head 同一份权重(第 6 节) |
flash_attn | True | 快速注意力 | 用 torch 的 scaled_dot_product_attention实现flash attention(03-自注意力机制精读) |
dropout | 0.0 | 训练正则 | 模型较小,默认不开 |
重点:intermediate_size = ⌈768·π/64⌉·64 = 2432
π ≈ 3.14系数把 FFN 中间层做成 hidden 的 ≈ 3.17 倍和 LLaMA 用8/3 ≈ 2.67倍、原版 Transformer 用 4 倍是同一类选择:FFN 需要一个宽的中间层来承担单 token 的非线性变换(见第 4 节);64对齐:把结果取整到 64 的倍数。现代 GPU / cuDNN 对某些维度的张量有专门优化,对齐维度经常能够得到提速
2.2 use_moe:一个 config 管两套架构
同一个 MiniMindConfig 实现Dense 和 MoE 两套模型切换:
# MiniMindBlock.__init__  (184 行)
self.mlp = FeedForward(config) if not config.use_moe else MOEFeedForward(config)
后面的 MoE 字段有:
self.num_experts = 4                # 4 个专家
self.num_experts_per_tok = 1        # 每个 token 只激活 top-1
self.moe_intermediate_size = ...    # 每个专家的 FFN 维度
self.norm_topk_prob = True          # top-k 权重再归一化
self.router_aux_loss_coef = 5e-4    # 负载均衡辅损失的系数
相关:这些字段来由(路由、top-k、aux loss)见 04-稀疏MoE路由与负载均衡
2.3 参数量统计
- Embedding / lm_head:(tie 后只算一份);
- 每层注意力:q/k/v/o 四个 ,×4 ≈ 2.4M(KV 头只有 4 个,k/v 其实是 ,又省了一块);
- 每层 FFN:gate/up 为 两份 + down 一份 ≈ 5.6M;
- 8 层后加上嵌入与 norm(norm 只有 个可学习参数),总额正好落在 ~64M(MoE 版 198M-A64M 的A64M就是激活 64M,第 4 篇给完整的统计)。
3. RMSNorm 精读
# model_minimind.py 50–60 行
class RMSNorm(torch.nn.Module):
    def __init__(self, dim: int, eps: float = 1e-5):
        super().__init__()
        self.eps = eps
        self.weight = nn.Parameter(torch.ones(dim))

    def norm(self, x):
        return x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + self.eps)

    def forward(self, x):
        return (self.weight * self.norm(x.float())).type_as(x)
3.1 关于RMSNorm公式
RMSNorm 沿最后一维(特征维)逐 token 归一化:
对比原版 LayerNorm:
差异点:RMSNorm 不减均值、不做方差中心化(只除均方根),同时没有 bias 项 ,只保留了一个缩放向量 (代码里叫 weight)。
3.2 使用RMSNorm的好处
这是 LLaMA 系(含 MiniMind)相对于原版 Transformer 的又一个现代化选择,理由有两条:
- Transformer 的归一化目标是让进入子模块的输入尺度稳定。LayerNorm 的均值项 在残差流里贡献极小注意力/FFN 输出都是残差写回主路,主路的均值早已被逐层吸收。RMSNorm 论文(Zhang & Sennrich, 2019)证明:只做除均方根这一步,效果几乎无损。
- 省掉均值减法、方差、bias,一次 forward 的归约运算更少;更关键的是省掉了 768 个 bias 参数的梯度计算。
3.3 工程上的要点
这 10 行代码里有四个值得注意的工程点:
| 写法 | 要点 |
|---|---|
torch.rsqrt(...) | 先求 再乘,用乘法代替除法GPU 上 rsqrt 有专用指令,比 x / sqrt(...) 快 |
x.float() 与 .type_as(x) | 归一化运算在 fp32 下做,算完再转回原 dtype(bf16/fp16)混合精度下避免低精度累加误差(与第 6 篇的 AMP 是同一条数值稳定思路) |
self.eps | 防除零的极小常数;模块默认 1e-5,但 MiniMind 构造时显式传入 config.rms_norm_eps=1e-6(见 Attention / MiniMindModel 里的 RMSNorm(dim, eps=config.rms_norm_eps)) |
3.4 它在模型里的位置
对照 1. 模型形状概览 的图:图中每个子模块(GQA / FFN)最前面的那个方块就是 RMSNormPre-Norm 的读这一步。全部用法共三处:
Attention内部:q_norm/k_norm(对 head_dim 归一化,第 2 篇讲 QK-Norm);MiniMindBlock:input_layernorm(注意力前)+post_attention_layernorm(FFN 前);MiniMindModel:堆叠之后的最终norm。
MiniMind 在 Embedding 之后没有立即做归一化(原版 Transformer 有 post-embedding norm)。Pre-Norm 下每个子模块自己管尺度,入口的 LN 就省掉了。
4. SwiGLU:三个线性层的门控 FFN
# model_minimind.py 136–146 行
class FeedForward(nn.Module):
    def __init__(self, config: MiniMindConfig, intermediate_size: int = None):
        super().__init__()
        intermediate_size = intermediate_size or config.intermediate_size   # 2432
        self.gate_proj = nn.Linear(config.hidden_size, intermediate_size, bias=False)
        self.down_proj = nn.Linear(intermediate_size, config.hidden_size, bias=False)
        self.up_proj  = nn.Linear(config.hidden_size, intermediate_size, bias=False)
        self.act_fn   = ACT2FN[config.hidden_act]   # 按 config.hidden_act 的名字查表取激活函数("silu")

    def forward(self, x):
        return self.down_proj(self.act_fn(self.gate_proj(x)) * self.up_proj(x))
4.1 SwiGLU公式
三个线性层特点:
gate_proj(768→2432):把 x 投影到门控空间,过SiLU激活;up_proj(768→2432):投影出候选值;两路逐元素相乘();down_proj(2432→768):把乘积压回残差流维度保证张量不变
4.2 关于门控的射界
原版 Transformer(2017)的 FFN 只有两个线性层:
SwiGLU(Shazeer, 2020)把Relu换成了门控分支:
门控:SiLU(W_gate·x) 输出在 之间(负输入被压到接近 0),相当于一个软开关对着候选值 的采纳。这和注意力、LSTM 里门是同一个思想多项实验(LLaMA 论文复述)表明 Gated Linear Unit 类结构在相同算力下困惑度更好。
因为多了第三层线性层,SwiGLU 模型的 FFN 中间维度会刻意调小以维持总参数量可比(LLaMA 用 hidden 的 8/3 倍,MiniMind 用 π 倍 ≈3.17,都是这个逻辑;若用原版 4 倍再加第三层,参数就超了)。
4.3 SiLU的优势
SiLU(= Swish)有三个性质:平滑(处处可导,梯度比 ReLU 在 0 点处更友好)、有下界无上界(比 ReLU 的硬截断更温和)、负区间不完全归零(保留微弱负信号)。对门来说,平滑的软开关通常比 ReLU 的硬开关训练更稳。
ACT2FN[config.hidden_act] 是从 transformers.activations 按字符串名字查表所以 hidden_act 改成 gelu 也是可以运行的
4.4 一个小细节
全部 bias=False:三个线性层都不带偏置。去掉 bias 后,线性层变成纯矩阵乘法。LLaMA / Qwen 系全线无 bias,也省了约 2432×3 个参数。
5. 残差结构与预归一化:MiniMindBlock 精读
# model_minimind.py 178–194 行
class MiniMindBlock(nn.Module):
    def __init__(self, layer_id: int, config: MiniMindConfig):
        super().__init__()
        self.self_attn = Attention(config)                    # 注意力子模块
        self.input_layernorm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)
        self.post_attention_layernorm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)
        self.mlp = FeedForward(config) if not config.use_moe else MOEFeedForward(config)

    def forward(self, hidden_states, position_embeddings, past_key_value=None,
                use_cache=False, attention_mask=None):
        residual = hidden_states
        hidden_states, present_key_value = self.self_attn(
            self.input_layernorm(hidden_states),               # ① 先归一化,再进注意力
            position_embeddings, past_key_value, use_cache, attention_mask
        )
        hidden_states += residual                              # ② 注意力输出写回残差流
        hidden_states = hidden_states + self.mlp(              # ③ 归一化后进 FFN,再写回
            self.post_attention_layernorm(hidden_states))
        return hidden_states, present_key_value
5.1 模型设计
- 子模块按属性挂载(
self.self_attn/self.mlp/ 两个self.*_layernorm)PyTorch 会把属性里的nn.Module自动注册进参数表 - 两个 RMSNorm 待在 Block 层,而不是藏在子模块内部:
input_layernorm部署于注意力入口、post_attention_layernorm部署于 FFN 入口。LLaMA / Qwen / MiniMind 都是这个布局归一化写在外面; residual = hidden_states先保存数据 → 子模块算增量 →+=写回。注意顺序:先+=(注意力残差),再mlp(...)(FFN 残差),两个残差分别绕过注意力和 FFN,互不交叉。
5.2 forward 里的三个透穿参数
Block 自身不需要这三个参数,只是原样透穿给注意力模块:
position_embeddings:预计算的 RoPE cos/sin 切片,注意力内部用它旋转 Q/K(02-RoPE位置编码与YaRN外推);past_key_value/use_cache:KV cache 的旧值与是否保留新值真正的拼接逻辑在Attention(03-自注意力机制精读);attention_mask:padding/跨序列掩码,同样进注意力。
5.3 和原版 Post-Norm 的最后一处差异
5.3.1 两种写法,一条梯度路径的差别
把 Block 缩写为 ,我们可以观察到:
是第 层的子模块(注意力或 FFN,含内部权重)。差别主要在反向传播时梯度的变化。
5.3.2 从雅可比矩阵看梯度衰减
Pre-Norm: 对 求导:
链式法则连乘 层,损失对最底层的梯度:
乘积展开后第一项恒为 它对应梯度沿残差主干道直通到底、一次都不穿过子模块的路径。即使所有 的特征值都小于 1、乘积部分指数衰减,这条恒等路径也始终以 1 的增益存在。(He et al. 2016 的 identity mapping)。
Post-Norm:归一化套在加法外面,, 前面多出一个归一化层的雅可比。RMSNorm/LayerNorm 对输入的雅可比近似为 的标量缩放(除方差那一步):
深层各层激活方差 不恒为 1,这个缩放因子乘 次就会指数级放大或衰减梯度每层都被进行一次归一化,浅层收不到稳定信号。
5.3.3 实践中的三个证据
- warmup:原版 2017 论文明确写we found increasing the learning rate… and using warmup12 层 Post-Norm 就依赖 4000 步学习率预热压住早期梯度爆炸。现代 Pre-Norm 模型(GPT-2 / LLaMA / Qwen / MiniMind)用大学习率就可以直接运行。
- 最终 norm 保证了尺度不变性:Pre-Norm 的代价是残差流尺度随深度缓慢漂移,所以堆叠之后必须再有最终
RMSNorm把尺度拉回、才好接lm_head,进阶读者可延伸阅读 Xiong et al. 2020 On Layer Normalization in the Transformer Architecture。
6. MiniMindModel
# model_minimind.py 196–232 行
class MiniMindModel(nn.Module):
    def __init__(self, config: MiniMindConfig):
        super().__init__()
        self.config = config
        self.vocab_size, self.num_hidden_layers = config.vocab_size, config.num_hidden_layers
        self.embed_tokens = nn.Embedding(config.vocab_size, config.hidden_size)   # 词表→768 查表
        self.dropout = nn.Dropout(config.dropout)                                  # 默认 0.0
        self.layers = nn.ModuleList([MiniMindBlock(l, config) for l in range(self.num_hidden_layers)])
        self.norm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)           # 堆叠外最终 norm
        freqs_cos, freqs_sin = precompute_freqs_cis(
            dim=config.head_dim, end=config.max_position_embeddings,               # 32768 长的 cos/sin 表
            rope_base=config.rope_theta, rope_scaling=config.rope_scaling)
        self.register_buffer("freqs_cos", freqs_cos, persistent=False)
        self.register_buffer("freqs_sin", freqs_sin, persistent=False)
6.1 模型组装
MiniMindModel 的本质是把前面各节零件按序组装,分工是:
| 组件 | 作用 | 来自 |
|---|---|---|
embed_tokens | 把 token id 查表成 [B, S, 768] 向量 | 本节 |
layers(8× Block) | 注意力机制和前馈神经网络 | 5. 残差结构与预归一化:MiniMindBlock 精读 |
norm | 堆叠外最终 RMSNorm,把尺度拉回 | 3. RMSNorm 精读 §3.4 / 5.3.3 实践中的三个证据 |
freqs_cos/sin | RoPE 的预计算位置表 | 第 3 篇详讲 |
6.2 RoPE buffer:为什么是 buffer,而且 persistent=False
precompute_freqs_cis 在 __init__ 时就把 32768 个位置 × 96 维的 cos/sin 表算好了,存成 buffer 而不是普通张量或参数:
- buffer vs 参数:buffer 参与前向、随模型
.to(device)迁移,但不产生梯度、不进优化器; persistent=False:不进state_dict,保存权重时不会把这 32768×96×2 的常数表写进.pth。表完全由max_position_embeddings / rope_theta / rope_scaling决定,当推理时想用 YaRN 外推(02-RoPE位置编码与YaRN外推)就得换一张表,它不该被固化进权重文件;
6.3 forward:切片、逐层循环、presents
start_pos = past_key_values[0][0].shape[1] if past_key_values[0] is not None else 0  # 已有缓存长度
hidden_states = self.dropout(self.embed_tokens(input_ids))
# ...
position_embeddings = (self.freqs_cos[start_pos:start_pos + seq_length],
                       self.freqs_sin[start_pos:start_pos + seq_length])              # RoPE 切片
presents = []
for layer, past_key_value in zip(self.layers, past_key_values):
    hidden_states, present = layer(hidden_states, position_embeddings,
                                   past_key_value=past_key_value, use_cache=use_cache,
                                   attention_mask=attention_mask)
    presents.append(present)
hidden_states = self.norm(hidden_states)   # 最终 norm
aux_loss = sum([l.mlp.aux_loss for l in self.layers if isinstance(l.mlp, MOEFeedForward)],
               hidden_states.new_zeros(1).squeeze())
return hidden_states, presents, aux_loss
四个细节:
start_pos:推理续写时,past_key_values[0][0]是第 0 层缓存的 K,.shape[1]就是已经算过的位置数。RoPE 切片从start_pos开始,新 token 拿到的是它真实的绝对位置( KV Cache) (见03-自注意力机制精读 );- 8 层循环复用同一个
position_embeddings:RoPE 表是纯位置函数,不随层变化,所以 8 层共享同一份切片; presents收集:每层返回(hidden_states, present),present为 None(训练)或新的 KV 元组(推理);aux_loss汇总:sum(..., 0)从 0 开始累加所有 MoE 层的负载均衡损失Dense 模型没有MOEFeedForward,这个和恒为 0,这兼容了两种架构(04-稀疏MoE路由与负载均衡)。
最后返回值 (hidden_states, presents, aux_loss) 三元组,留给上层封装 MiniMindForCausalLM (Transformers库)
7. MiniMindForCausalLM:把向量变回概率并计算损失
# model_minimind.py 234–253 行
class MiniMindForCausalLM(PreTrainedModel, GenerationMixin):
    config_class = MiniMindConfig
    _tied_weights_keys = {"lm_head.weight": "model.embed_tokens.weight"}

    def __init__(self, config: MiniMindConfig = None):
        self.config = config or MiniMindConfig()
        super().__init__(self.config)
        self.model = MiniMindModel(self.config)
        self.lm_head = nn.Linear(self.config.hidden_size, self.config.vocab_size, bias=False)
        if self.config.tie_word_embeddings:
            self.model.embed_tokens.weight = self.lm_head.weight   # ★ 共享权重
        self.post_init()

    def forward(self, input_ids, attention_mask=None, past_key_values=None,
                use_cache=False, logits_to_keep=0, labels=None, **kwargs):
        hidden_states, past_key_values, aux_loss = self.model(input_ids, attention_mask,
                                                              past_key_values, use_cache, **kwargs)
        slice_indices = slice(-logits_to_keep, None) if isinstance(logits_to_keep, int) else logits_to_keep
        logits = self.lm_head(hidden_states[:, slice_indices, :])
        loss = None
        if labels is not None:
            x, y = logits[..., :-1, :].contiguous(), labels[..., 1:].contiguous()
            loss = F.cross_entropy(x.view(-1, x.size(-1)), y.view(-1), ignore_index=-100)
        return MoeCausalLMOutputWithPast(loss=loss, aux_loss=aux_loss, logits=logits,
                                         past_key_values=past_key_values, hidden_states=hidden_states)
7.1 为什么需要进行这层封装
这是为了兼容Transformers库生态,同时将输出概率变为输出预测目标
7.2 tie_word_embeddings:Linear和 Embedding如何共享参数
7.2.1 数学本质:Embedding 就是查表版的 Linear
nn.Embedding(6400, 768) 的 weight 是一张 [6400, 768] 的矩阵。给定 token id ,它返回第 行:weight[i]。从 one-hot 视角来看:
one-hot 向量右乘矩阵,结果恰好是矩阵第 行查表就是one-hot 乘法。
而 nn.Linear(768, 6400, bias=False) 是:
两个模块的权重矩阵形状完全一致,都是 [6400, 768]。
| 形状 | 用法 | |
|---|---|---|
| Embedding.weight | [6400, 768] | 按行索引取值(token id → 第 i 行当向量) |
| Linear.weight | [6400, 768] | 按矩阵乘法用(转置后内积) |
所以二者可以共享同一张表。
7.2.2 实现
self.model.embed_tokens.weight = self.lm_head.weight把 lm_head 的 Parameter 对象整个挂到 embed_tokens.weight 属性上:
- 前向:Embedding 从这张表取第 行,Linear 用这张表转置后内积;
- 反向:两路梯度(查表的 、投影的 )累加进同一个
.grad; - 更新:优化器只看到一个参数对象,Adam 的状态(exp_avg 等)也只有一份因为本来就只有一个参数。
PyTorch 之所以允许,正是因为 nn.Linear.weight 和 nn.Embedding.weight 都是普通 Parameter,而这里两者的形状恰好对齐(out_features = vocab_size、in_features = embedding_dim)。
模型不必学两套需要对齐的词表。参数省 7~8%,且嵌入空间与输出空间被强制一致。
7.2.4 两个小细节
_tied_weights_keys = {lm_head.weight: model.embed_tokens.weight}:告诉 transformers 保存/加载时这两个名字指向同一份权重,防止重复序列化或加载不一致;- 梯度是两路之和:同一权重同时受入口查表和出口投影两个任务训练,等效于一个双任务共享表示这是 MiniMind 把 SFT 学习率压到 1e-5 量级的原因(06-训练循环工程精读)。
7.3 shifted CE loss:自回归目标的落点
自回归的定义是用前 个 token 预测第 个。所以 logits 与 labels 错开一位对齐:
x, y = logits[..., :-1, :].contiguous(), labels[..., 1:].contiguous()
loss = F.cross_entropy(x.view(-1, x.size(-1)), y.view(-1), ignore_index=-100)ignore_index=-100:PyTorch CE 的约定label 为-100的位置不参与损失。MiniMind 用它屏蔽两种东西:padding 位置(05-数据管线与自回归目标设计 的PretrainDataset把 pad 标成 -100)与 SFT 里的 prompt 部分(只监督回答,SFTDataset.generate_labels见第 5 篇);view(-1, 6400):把[B, S-1, 6400]展平成[B·(S-1), 6400],一次算完所有位置的 CE。
7.4 两个半隐藏设计:logits_to_keep 与 MoeCausalLMOutputWithPast
logits_to_keep:推理续写时,其实只需要最后一个位置的 logits 来采样下一个 token(generate里outputs.logits[:, -1, :])。传入logits_to_keep=1就只算最后一个位置的输出,省掉整条词表维度的计算与显存。RL 训练时(GRPO/PPO)它被用来只算响应部分的 logits08-偏好对齐:DPO与强化学习 的 rollout 引擎里logits_to_keep=n_keep+1就是这么用的;
8. 参数统计表
8.1 参数总量
以 hidden=768, layers=8, heads=8, kv_heads=4, head_dim=96, vocab=6400, intermediate=2432 精确复算:
| 模块 | 计算 | 参数量 |
|---|---|---|
| Embedding / lm_head(tie 共享,只计一份) | 4.92M | |
| 每层 q_proj | 0.59M | |
| 每层 k_proj | 0.29M | |
| 每层 v_proj | 0.29M | |
| 每层 o_proj | 0.59M | |
| 每层 FFN(gate+up+down) | 5.60M | |
| 每层 Block 合计 | 7.37M | |
| 8 层 × Block | × 8 | 58.96M |
| RMSNorm scale(8×2+1 处,忽略级) | ~0.01M | |
| 总计(Dense) | ≈ 63.9M ≈ 64M ✓ |
9.2 get_model_params
MiniMind 打印参数量的工具函数(trainer_utils.py 18–28 行)同时服务两种架构:
total = sum(p.numel() for p in model.parameters()) / 1e6
n_routed = getattr(config, 'n_routed_experts', getattr(config, 'num_experts', 0))
n_active = getattr(config, 'num_experts_per_tok', 0)
expert = sum(p.numel() for n, p in model.named_parameters() if 'mlp.experts.0.' in n) / 1e6
base = total - expert * n_routed                    # 总参数 - 全部专家参数
active = base + expert * n_active # 只算每个 token 实际激活的专家- Dense 模型:
active == total,Model Params: 63.88M; - MoE 模型:
198M-A64M总参 198M,但每个 token 只路由到 1 个专家,激活参数仅 64M,A = active。
评论